
双面扫描入档指南:奇偶页序合并、中英文OCR校对与可搜寻PDF整理
双面文件扫描后页码奇偶错乱、按 Ctrl+F 又搜不到字?从奇偶页交错合并、中英文混排 OCR 设定到可搜寻 PDF 校对一次理清!
主题摘要
为什么扫描完的 PDF 总是页码跳号、按 Ctrl+F 却什么都搜不到?📄🔍
大家在整理厚厚的纸本讲义、会议纪录或跨年合约时,是不是也常遇到这两个让人崩溃的瞬间:第一,如果手边的自动进纸扫描器(ADF)只支援单面进纸,正面扫完一叠「1、3、5、7 页」,翻面再扫一叠「8、6、4、2 页」,最后产出两个页码完全颠倒拆开的 PDF 档;第二,好不容易把页面顺序排好,急著想在几十页的档案里按 Ctrl+F(或 Mac 的 Cmd+F)找某个条款关键字,电脑却冷冷地显示「找不到相符项目」——因为扫描器预设输出的只是「一张张装进 PDF 外壳的静态图片」,根本没有任何电脑读得懂的文字编码!🫠
根据 Adobe Acrobat 光学文字辨识(OCR)官方技术指南 与开源工具 PDFsam Basic 交错合并文件说明,要把纸本双面文件转化为真正好用的「可搜寻数位档案(Searchable PDF)」,核心工作其实分成三个紧密衔接的步骤:先对齐奇偶页序与方向、再叠加中英文 OCR 隐藏文字层、最后抽查易错字元与检索索引。如果你平时还会把这类扫描文献汇入书目软件管理,也可以搭配兔兔先前整理的 Zotero文献汇入:重复记录与引用资料清理 一起对照。
第一步:奇偶页交错合并(Alternate Mix)与页面预览检查 🗂️✨
面对单面进纸扫描器产出的「正面奇数页档」与「反面偶数页档(通常还是倒序:最后一页在最前面)」,千万别傻傻地用滑鼠一页一页手动拖拉!在第一组影片中,兔兔帮大家挑出了免费工具 PDFsam Basic、PDF24 Creator 与 PDF-XChange 的页面管理实战:
- 奇偶页交错合并与反向排序:当反面扫描档是从最后一页往前扫时,利用交错合并(Alternate Mix)功能并勾选「第二份档案反向读取(Reverse second document)」,系统就会自动按照「正 1 → 反 2 → 正 3 → 反 4」的顺序精准穿插合成单一档案。
- 执行 OCR 前必做的版面清理:在送进 OCR 引擎辨识前,先打开缩图检视(Thumbnail View),把扫歪或上下颠倒的页面转正(90 度或 180 度旋转),并删掉双面扫描时多余的纯白背面页。因为页面一旦颠倒或歪斜超过一定角度,OCR 的文字辨识准确率就会大幅暴跌。
第二步:中英文混排 OCR 输出模式挑选与文字层校对 🔤🧐
当页序与方向都端正之后,就进入最关键的 OCR(Optical Character Recognition,光学文字辨识) 阶段。跟著第二组与第三组影片实测时,兔兔提醒大家特别留意三个实务细节:
- 必须同时勾选「繁体中文+英文」双语辨识字典:许多学术论文、财务报表或商业合约都是中英夹杂(例如中文段落里夹带英文专有名词、型号或缩写)。如果在 OCR 设定里只选单一语言,另一种语言的字元就会被硬生生拆解成乱码符号。
- 分清「可搜寻影像(Searchable Image)」与「可编辑文字(Editable Text)」的用途差异:正式合约、公文或带有签名印章的单据归档时,建议优先选择「保留原始扫描影像外观、仅在底层叠加隐藏文字层(Searchable Image)」模式。这样既不会因为字型替换而破坏原本的排版与印鉴位置,又能支援游标反白复制与全文关键字搜寻。
- 针对数字、标点与形近字做抽样校对:不论软件标榜多高的辨识率,当原稿纸张有折痕、萤光笔画记或解析度低于 300 DPI 时,像是数字
0与英文字母O、1与l,或是繁体笔画密集的字(如「体 / 礼」、「己 / 已 / 巳」)仍可能误判。完成 OCR 后,务必先试按Ctrl+F搜寻几个核心专有名词与金额数字,确认能精准跳转定位再正式存档归库!🐰💡
🎬 双面扫描后的奇偶页序合并、页面旋转与空白页清理
PDFsam Basic 与免费工具实测:多档批次合并与页面穿插整理
当你用单面自动进纸器把文件正面(奇数页)与反面(偶数页)分成两个档案扫描后,最怕手动一页页插入排到眼花。这支影片实测开源免费工具 PDFsam Basic 与常见 PDF 合并方案的操作介面,示范如何批次汇入多份扫描档、设定页面范围与合并顺序,在不破坏原始扫描画质的前提下快速合成完整文件。📂
展开观看参考原片(YouTube)
PDF24 页面管理全流程:缩图拖曳调整页序、旋转倒置页面与删空白页
双面扫描进档后,常会夹杂几页因为纸张放反而上下颠倒的页面,或是背面空白页。Meiko 老师一步步示范如何用免费的 PDF24 工具箱展开全页缩图,直觉拖曳对调错乱页码、单独旋转特定倒置页面并剔除多余空白页。先把版面方向修正好再跑 OCR,才不会让辨识引擎读出整页乱码!🔄
展开观看参考原片(YouTube)
PDF-XChange 页次调整教学:快速核对纸本页码与数位页序
短小精悍的实务操作示范!影片展示在 PDF-XChange 中开启侧边页面缩图面板,当发现扫描档中间有跳页或奇偶页穿插错位时,如何直接选取单页或连续页面区间移动至正确页次位置,确保数位 PDF 的页码编号与纸本原稿页码完全一致。📑
展开观看参考原片(YouTube)
🎬 中英文混排 OCR 光学文字辨识与输出模式设定
Right PDF 文电通 OCR 实战:多语言辨识设定与「可被搜寻」输出模式比较
这支官方教学非常清楚地拆解了执行 OCR 时最核心的两个参数:一是「辨识语言选择」(若扫描档同时包含繁体中文与英文务必一并勾选),二是「输出样式」的差异——究竟该选保留原稿外观并叠加文字层的「可被搜寻影像」,还是直接转为「可被搜寻与编辑的文字」,一看就懂怎么按文件性质挑选。🔤
展开观看参考原片(YouTube)
3 种 PDF OCR 文字辨识方法横向实测:桌面软件、线上工具与浏览器内建功能
临时有一份扫描版 PDF 无法选取复制文字,该用哪种工具处理?影片实测对比了专业桌面 OCR 软件、免费线上工具与浏览器内建辨识功能在处理复杂表格、多栏排版与中英文混排扫描档时的表现,并提醒哪些高机密文件适合留在离线桌面端处理。💡
展开观看参考原片(YouTube)
繁体中文扫描档 OCR 实测:从纯影像 PDF 转为可复制搜寻的文字层
针对繁体中文笔画较多、常夹杂全形标点与阿拉伯数字的扫描文件,影片实际示范汇入图片型 PDF 并执行中文 OCR 辨识的完整步骤,让大家直观看到辨识完成后如何直接反白选取段落、检查错别字并复制文字内容。🧐
展开观看参考原片(YouTube)
🎬 可搜寻 PDF 文字层校对、Ctrl+F 检索验证与批次归档
扫描文件批次 OCR、文字校对修订与归档前容量压缩工作流
当你一次扫描了几十页双面讲义或跨国报告,除了跑完 OCR 建立文字层外,往往还需要修正个别辨识错误的字词并缩小档案体积。影片从 03:16 起展示如何将 OCR 辨识、页面文字微调校对与归档压缩串成流畅的数位化工作流。⚡
展开观看参考原片(YouTube)
Adobe Acrobat 可搜寻 PDF 验证示范:Recognize Text 与 Ctrl+F 关键字检索检查
许多办公室与学校电脑都装有 Adobe Acrobat,这支英文短片干净俐落地示范开启一张完全无法反白选字的扫描 PDF,进入「Scan & OCR → Recognize Text」指定页面范围与语言,并在辨识完成后立即用游标框选与 `Ctrl+F` 搜寻关键字来验证文字层是否成功写入档案。🔍
展开观看参考原片(YouTube)
兔兔推荐
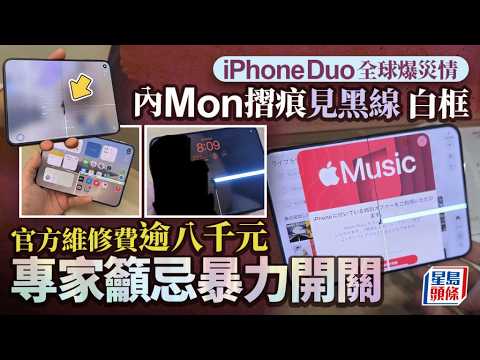
iPhone Duo 灾情与拆解:内屏爆裂原因、贴膜禁忌与官方免费换机
苹果首款折叠机 iPhone Duo 开卖即爆「内屏幕破裂灾情(Crackgate)」!兔兔整合全球首发苦主实况、iFixit 工业 CT 扫描拆解元凶、副厂钢化膜翻车警告,以及苹果官方最新免费换机保固政策。

延长插座不够用怎么办:电器瓦数负载计算与延长线安全选用
插座不够插,延长线接延长线超危险?别让居家便利变成走火隐患!由家电铭牌瓦数计算、墙面插座回路限制到合格防过载延长线挑选,兔兔帮你理清安全用电重点。

USB4扩充坞接双屏幕怎么挑:频宽、供电与相容性避坑指南
都是Type-C插头,为何外接双屏幕不是黑屏就是只能镜像?兔兔带大家拆解USB4满血40Gbps频宽、Mac与Windows的MST协定差异,以及PD供电瓦数扣留陷阱,轻松搞定桌面多屏扩展。

Zotero文献汇入:重复记录与引用资料清理
系统梳理 Zotero 文献管理工具在大量汇入论文时的标准流程,涵盖 Zotero Connector 网页抓取、重复项目智慧合并、期刊元数据(Metadata)清洗与缺漏栏位补全指南。
今次揾到嘅主题就咁多,迟啲再嚟啦。
呢篇用咗 AI 协助整理,亦有人编辑,仍可能有错漏或偏差。 如果你系片主而唔想影片喺呢度展示,请联络我哋。